
К июлю 2026 года Google, по подсчётам автора исходной статьи, прекратил поддержку девяти типов элементов в галерее расширенных результатов поиска. Последним из упомянутых стало оформление FAQ и FAQPage: его удаление вызвало споры о будущем Schema.org и о том, нужна ли разметка, если она больше не даёт привычного поискового преимущества.
Автор предлагает смотреть на техническое SEO шире: задача состоит не только в том, чтобы сделать страницу доступной для сканирования, но и в том, чтобы машины могли правильно распознавать сущности, связи и содержание сайта. Структурированная разметка при этом — лишь один из нескольких слоёв целостности данных.
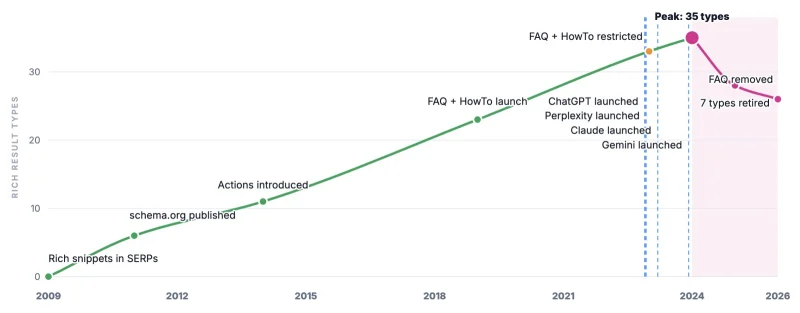
Отмена расширенного результата не означает отмену схемы
В сообщении Google об FAQ говорилось, что в июне 2026 года компания уберёт соответствующее оформление в поиске, отчёт о расширенных результатах и поддержку в инструменте их проверки. Автор подчёркивает: речь шла о функции отображения, а не об отказе от самой разметки FAQ. При этом другие типы, например Product, продолжают расширяться.
Это не означает, что добавление Schema.org автоматически увеличит число цитирований в ответах ИИ. Джанлука Фиорелли обращал внимание, что эксперименты по влиянию разметки на цитирование могут проводиться на ограниченных наборах данных. По мнению автора, оценивать её пользу только по цитированиям и показам тоже недостаточно.
Сугантан Моханадасан описывал три «жизни» схемы: в конвейере индексации Google, в предварительном обучении больших языковых моделей — косвенно — и при поиске информации моделью во время работы. Автор рассматривает разметку как слой для понимания сущностей и отношений, хотя не утверждает, что она гарантирует результат в каждом из этих сценариев.
Почему неоднозначность опасна для данных
Когда название или факт можно трактовать по-разному, агент или языковая модель рискует выбрать неверную интерпретацию. По мнению автора, такие ошибки могут накапливаться: ответ отдаляется от фактов, а при попадании неточных данных в обучение последствия потенциально сохраняются дольше.
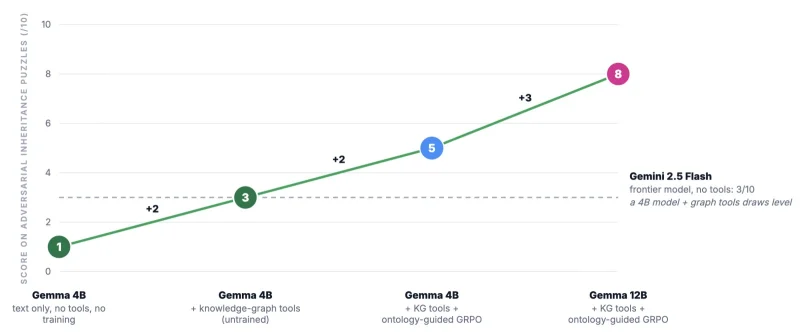
В качестве примера автор ссылается на работу Андреа Вольпини и Кьяры Карроццы «Sangue e Grafi: Teaching a Small Model to Read the Bloodline». В ней ведущие модели, как отмечается в статье, склонялись к связному повествованию в ущерб фактам, тогда как небольшая модель с инструментами графа знаний смогла достичь сопоставимого результата. Это аргумент в пользу явных связей между данными, а не доказательство того, что одна разметка устраняет ошибки ИИ.
Пять слоёв целостности данных
Автор выделяет пять слоёв, которые помогают рассматривать сайт с точки зрения машинного понимания:
Сущности. Нужно определить, что существует и чем является объект: например, организация или человек. Стабильные идентификаторы @id и привязка к авторитетным источникам, таким как Wikidata, GS1, ISNI или ORCID, помогают различать одноимённые сущности.
Отношения. Важно явно описать, как сущности связаны друг с другом. Для этого используются, в частности, @id, sameAs и RDF. Среди инструментов автор называет агрегацию схемы в Yoast SEO и EntityMap Диксона Джонса.
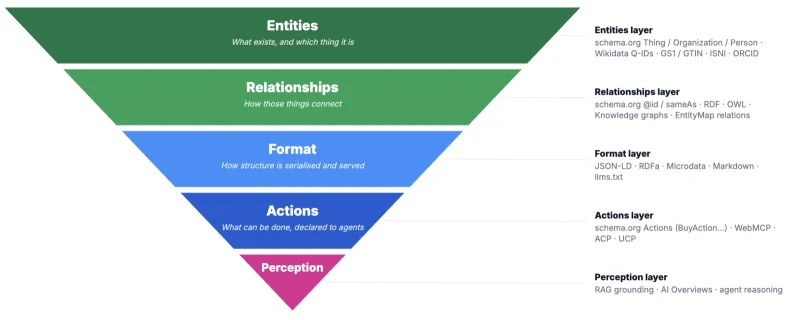
Формат. Данные должны быть структурированы и доступны для потребления. К этому слою автор относит JSON-LD, RDFa и Microdata, а также Markdown, файлы llms.txt и agents.md, OKF и способы предоставления данных через согласование содержимого, ARD и MCP.
Действия. Сайт может сообщать агентам, что с ним можно делать. Примеры включают действия Schema.org, такие как BuyAction, а также более новые WebMCP, ACP и UCP.
Восприятие. Этот слой связан с внешним подтверждением, сторонним восприятием и тональностью упоминаний. В отличие от первых четырёх слоёв, владелец сайта не полностью контролирует его.
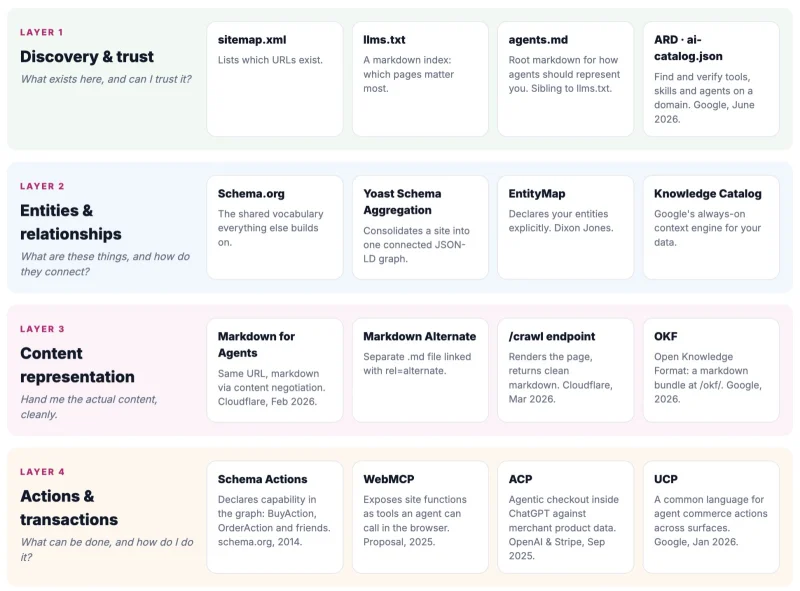
Агрегация, инструкции и потребление данных
В статье от октября 2025 года автор писал, что SEO-специалистам придётся учитывать обе стороны веба и обеспечивать работу с ними. В июле 2026 года он разделил перечисленные форматы, инструменты и протоколы на три группы по их назначению.
Агрегация. Sitemap.xml собирает канонические URL в XML-индексе; llms.txt даёт обзор содержимого сайта с важной информацией и направлениями для дальнейшего чтения. Yoast Schema Aggregation объединяет JSON-LD отдельных страниц в связанный граф сайта, а EntityMap формирует явную карту объявленных сущностей. Knowledge Catalog собирает структурированные, неструктурированные и SaaS-данные в управляемый контекстный механизм; OKF — знания сайта в набор Markdown-файлов по пути /okf/; ARD и ai-catalog.json — инструменты и агентов домена в каталог. OpenKB компилирует исходные документы в вики на Markdown.
Инструкции. Schema.org предоставляет общий словарь значений для машин. Файл agents.md, по описанию автора, задаёт агентам правила представления сайта и взаимодействия с ним.
Потребление. Markdown for Agents позволяет отдавать чистый Markdown по тому же URL через согласование содержимого; альтернативный Markdown-вывод предполагает отдельную версию .md, связанную через rel=alternate. Эндпоинт /crawl по запросу преобразует страницу или сайт в Markdown. WebMCP предоставляет действия сайта как инструменты для агента, а NLWeb использует схемы, фиды и карты сайта для ответов на запросы на естественном языке. ACP предназначен для оформления агентом покупки в ChatGPT на основе данных товаров продавца, UCP — для описания действий агентной коммерции на разных платформах.
По мнению автора, эти подходы могут сокращать число запросов и повышать эффективность использования токенов. Однако перечисление включает решения с разными задачами и не означает, что каждому сайту нужны все из них.
Проблема стандартов и выбор приоритетов
Schema.org возник благодаря согласованию между Google, Microsoft/Bing и Yahoo!, к которым позднее присоединился Yandex. По словам автора, похожим образом пятью годами ранее поисковые компании согласовали стандарт XML sitemap. Для новых агентных подходов такого общего консенсуса, по его оценке на июль 2026 года, нет: даже способы потребления данных, включая применение Markdown, остаются предметом споров.
Поэтому автор советует выбирать решения с учётом целей сайта и технического долга, а не внедрять всё сразу. Предлагаемый порядок таков:
1. Стабилизировать идентификаторы @id и добавить связи sameAs с Wikidata и другими авторитетными источниками: на сущностях и их идентификации строится остальная работа.
2. Проверить с помощью NLWeb, как данные сайта фактически интерпретируются, вместо того чтобы предполагать, что граф читается именно так, как задумано.
3. Для интернет-магазина сначала проверить товарный фид и изучить BuyAction и изменения схемы Product. Автор отмечает, что на момент публикации в заметном масштабе применялись лишь ReadAction и SearchAction, поэтому поле для других действий оставалось открытым.
4. Рассмотреть внедрение WebMCP. По описанию автора, он применим не только в электронной коммерции, но и на других сайтах.
5. Отложить выдачу Markdown и согласование содержимого до появления свободных ресурсов разработки, если только доступный инструмент, например Cloudflare Markdown for Agents, не упрощает задачу.
6. Изучить OKF и ARD как подходы к тому, как агент или языковая модель может понимать сайт целиком.
Не только протоколы, но и качество исходных данных
Автор не предлагает делать ставку на одного будущего победителя среди протоколов. Его аргумент состоит в том, что подготовка к работе с разными агентами заставляет внимательнее оценивать интерпретацию сайта. Для небольших экспериментов можно использовать отдельный проект: в исходной статье автор описал свой личный сайт, на котором применял согласование содержимого, альтернативный Markdown, llms.txt и WebMCP.
Общая основа этих подходов — точные сущности, явные связи и содержание, которое машина может прочитать без лишних догадок. По мнению автора, наряду с позициями в поиске SEO-специалистам стоит уделять внимание доверию, точности и целостности данных, не принимая поддержку нового протокола за гарантию успеха.
Комментариев пока нет. Начните обсуждение.