
До липня 2026 року Google, за підрахунками автора вихідної статті, припинив підтримку дев’яти типів елементів у галереї розширених результатів пошуку. Останнім зі згаданих стало оформлення FAQ і FAQPage: його видалення викликало суперечки про майбутнє Schema.org і про те, чи потрібна розмітка, якщо вона більше не дає звичної пошукової переваги.
Автор пропонує дивитися на технічне SEO ширше: завдання полягає не лише в тому, щоб зробити сторінку доступною для сканування, а й у тому, щоб машини могли правильно розпізнавати сутності, зв’язки та вміст сайту. Структурована розмітка при цьому — лише один із кількох шарів цілісності даних.
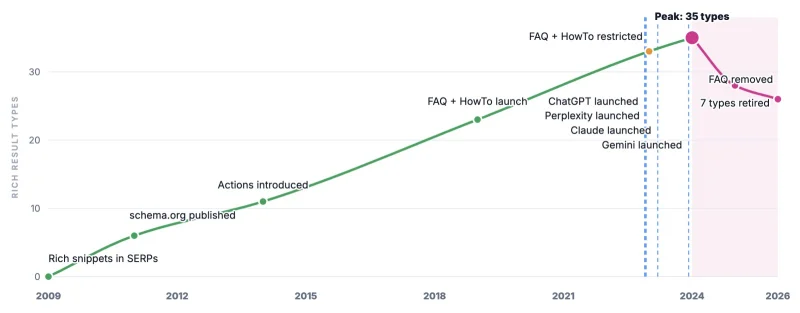
Скасування розширеного результату не означає скасування схеми
У повідомленні Google про FAQ йшлося, що в червні 2026 року компанія прибере відповідне оформлення в пошуку, звіт про розширені результати та підтримку в інструменті їх перевірки. Автор наголошує: йшлося про функцію відображення, а не про відмову від самої розмітки FAQ. Водночас інші типи, наприклад Product, продовжують розширюватися.
Це не означає, що додавання Schema.org автоматично збільшить кількість цитувань у відповідях ШІ. Джанлука Фіореллі звертав увагу, що експерименти щодо впливу розмітки на цитування можуть проводитися на обмежених наборах даних. На думку автора, оцінювати її користь лише за цитуваннями та показами теж недостатньо.
Сугантан Моханадасан описував три «життя» схеми: у конвеєрі індексації Google, у попередньому навчанні великих мовних моделей — опосередковано — і під час пошуку інформації моделлю в процесі роботи. Автор розглядає розмітку як шар для розуміння сутностей і зв’язків, хоча й не стверджує, що вона гарантує результат у кожному з цих сценаріїв.
Чому неоднозначність небезпечна для даних
Коли назву або факт можна трактувати по-різному, агент або мовна модель ризикує обрати неправильну інтерпретацію. На думку автора, такі помилки можуть накопичуватися: відповідь віддаляється від фактів, а якщо неточні дані потрапляють у навчання, наслідки потенційно зберігаються довше.
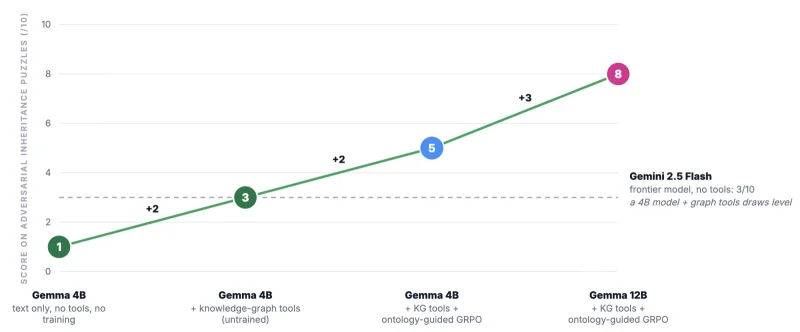
Як приклад автор посилається на роботу Андреа Вольпіні та К’яри Карроцци «Sangue e Grafi: Teaching a Small Model to Read the Bloodline». У ній провідні моделі, як зазначається у статті, схилялися до зв’язної оповіді на шкоду фактам, тоді як невелика модель з інструментами графа знань змогла досягти порівнянного результату. Це аргумент на користь явних зв’язків між даними, а не доказ того, що сама лише розмітка усуває помилки ШІ.
П’ять шарів цілісності даних
Автор виокремлює п’ять шарів, які допомагають розглядати сайт з погляду машинного розуміння:
Сутності. Потрібно визначити, що існує і чим є об’єкт: наприклад, організацією чи людиною. Стабільні ідентифікатори @id і прив’язка до авторитетних джерел, таких як Wikidata, GS1, ISNI або ORCID, допомагають розрізняти однойменні сутності.
Зв’язки. Важливо явно описати, як сутності пов’язані одна з одною. Для цього використовуються, зокрема, @id, sameAs і RDF. Серед інструментів автор називає агрегацію схеми в Yoast SEO та EntityMap Діксона Джонса.
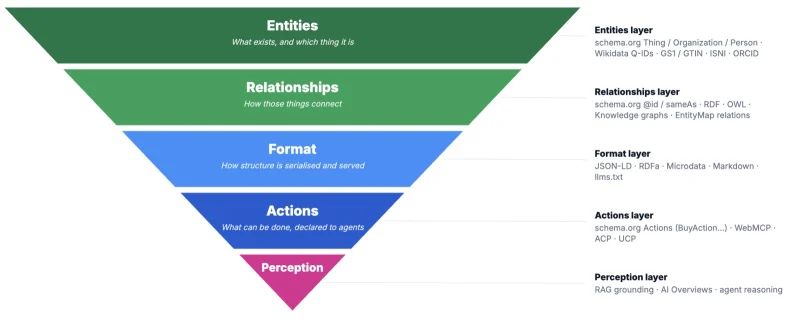
Формат. Дані мають бути структуровані та доступні для споживання. До цього шару автор зараховує JSON-LD, RDFa і Microdata, а також Markdown, файли llms.txt і agents.md, OKF і способи надання даних через узгодження вмісту, ARD і MCP.
Дії. Сайт може повідомляти агентам, що з ним можна робити. Приклади включають дії Schema.org, такі як BuyAction, а також новіші WebMCP, ACP і UCP.
Сприйняття. Цей шар пов’язаний із зовнішнім підтвердженням, стороннім сприйняттям і тональністю згадок. На відміну від перших чотирьох шарів, власник сайту не повністю контролює його.
Агрегація, інструкції та споживання даних
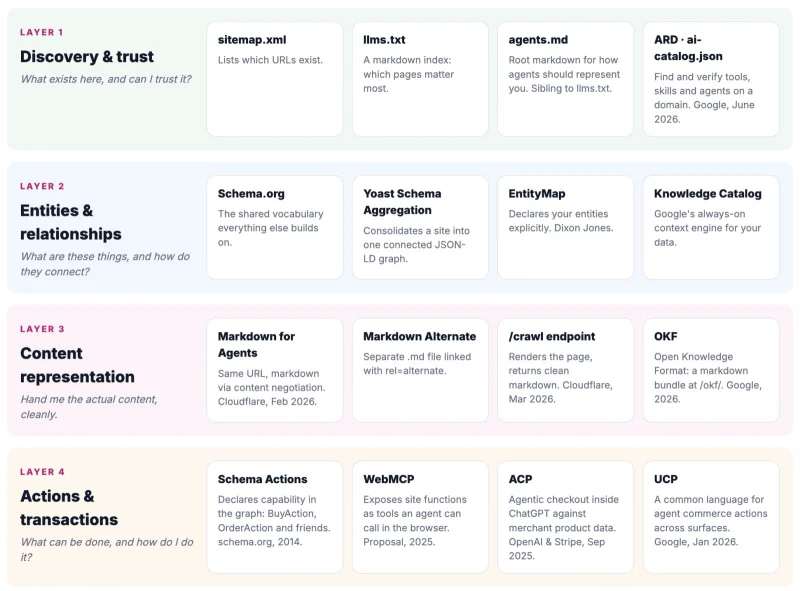
У статті від жовтня 2025 року автор писав, що SEO-фахівцям доведеться враховувати обидві сторони вебу та забезпечувати роботу з ними. У липні 2026 року він розділив перелічені формати, інструменти й протоколи на три групи за їхнім призначенням.
Агрегація. Sitemap.xml збирає канонічні URL в XML-індексі; llms.txt дає огляд вмісту сайту з важливою інформацією та напрямами для подальшого читання. Yoast Schema Aggregation об’єднує JSON-LD окремих сторінок у зв’язаний граф сайту, а EntityMap формує явну карту оголошених сутностей. Knowledge Catalog збирає структуровані, неструктуровані та SaaS-дані в керований контекстний механізм; OKF — знання сайту в набір Markdown-файлів за шляхом /okf/; ARD і ai-catalog.json — інструменти й агентів домену в каталог. OpenKB компілює вихідні документи у вікі на Markdown.
Інструкції. Schema.org надає спільний словник значень для машин. Файл agents.md, за описом автора, задає агентам правила представлення сайту та взаємодії з ним.
Споживання. Markdown for Agents дозволяє віддавати чистий Markdown за тим самим URL через узгодження вмісту; альтернативний Markdown-вивід передбачає окрему версію .md, пов’язану через rel=alternate. Ендпоінт /crawl на запит перетворює сторінку або сайт на Markdown. WebMCP надає дії сайту як інструменти для агента, а NLWeb використовує схеми, фіди та карти сайту для відповідей на запити природною мовою. ACP призначений для оформлення агентом покупки в ChatGPT на основі даних товарів продавця, UCP — для опису дій агентної комерції на різних платформах.
На думку автора, ці підходи можуть скорочувати кількість запитів і підвищувати ефективність використання токенів. Однак перелік включає рішення з різними завданнями й не означає, що кожному сайту потрібні всі вони.
Проблема стандартів і вибір пріоритетів
Schema.org виник завдяки узгодженню між Google, Microsoft/Bing і Yahoo!, до яких пізніше приєднався Yandex. За словами автора, схожим чином п’ятьма роками раніше пошукові компанії узгодили стандарт XML sitemap. Для нових агентних підходів такого спільного консенсусу, за його оцінкою станом на липень 2026 року, немає: навіть способи споживання даних, зокрема застосування Markdown, залишаються предметом суперечок.
Тому автор радить обирати рішення з урахуванням цілей сайту й технічного боргу, а не впроваджувати все одразу. Пропонований порядок такий:
1. Стабілізувати ідентифікатори @id і додати зв’язки sameAs з Wikidata та іншими авторитетними джерелами: на сутностях та їхній ідентифікації будується решта роботи.
2. Перевірити за допомогою NLWeb, як дані сайту фактично інтерпретуються, замість того щоб припускати, що граф читається саме так, як задумано.
3. Для інтернет-магазину спочатку перевірити товарний фід і вивчити BuyAction та зміни схеми Product. Автор зазначає, що на момент публікації в помітному масштабі застосовувалися лише ReadAction і SearchAction, тому поле для інших дій залишалося відкритим.
4. Розглянути впровадження WebMCP. За описом автора, він застосовний не лише в електронній комерції, а й на інших сайтах.
5. Відкласти видачу Markdown та узгодження вмісту до появи вільних ресурсів розробки, якщо тільки доступний інструмент, наприклад Cloudflare Markdown for Agents, не спрощує завдання.
6. Вивчити OKF і ARD як підходи до того, як агент або мовна модель може розуміти сайт у цілому.
Не лише протоколи, а й якість вихідних даних
Автор не пропонує робити ставку на одного майбутнього переможця серед протоколів. Його аргумент полягає в тому, що підготовка до роботи з різними агентами спонукає уважніше оцінювати інтерпретацію сайту. Для невеликих експериментів можна використовувати окремий проєкт: у вихідній статті автор описав свій особистий сайт, на якому застосовував узгодження вмісту, альтернативний Markdown, llms.txt і WebMCP.
Спільна основа цих підходів — точні сутності, явні зв’язки та вміст, який машина може прочитати без зайвих здогадок. На думку автора, поряд із позиціями в пошуку SEO-фахівцям варто приділяти увагу довірі, точності та цілісності даних, не сприймаючи підтримку нового протоколу як гарантію успіху.
Коментарів поки немає. Почніть обговорення.