
Можна запустити кампанію, отримати реальні заявки або покупки й при цьому побачити в рекламному кабінеті менше конверсій, ніж показує партнерка, CRM або трекер. На перший погляд здається, що десь зламалася статистика. На практиці частина подій справді може загубитися дорогою — ще до того, як рекламна система встигне нормально їх зафіксувати.
Нещодавно вже виходила новина про Google Tag Gateway для Demand Gen. Google повідомив, що рекламодавці, які посилили збір даних за допомогою Tag Gateway, у середньому побачили понад 20% приросту конверсій у Demand Gen. Але сприймати цю цифру як гарантовані +20% нових продажів точно не варто: йдеться про середній результат внутрішнього аналізу Google, а сама технологія насамперед допомагає зробити передачу даних стабільнішою та дати рекламній системі більше якісних сигналів.
Що більше реальних конверсій бачить рекламна система, то повнішими є дані, на яких навчається її алгоритм.
Чому рекламний кабінет взагалі може втрачати конверсії
За звичайного вебтрекінгу більша частина подій передається через браузер користувача. Людина клікає по рекламі, заходить на сайт, на сторінці спрацьовує тег або піксель, після чого інформація має повернутися до рекламної системи.
Проблема в тому, що між сайтом і рекламною платформою знаходиться браузер зі своїми обмеженнями, налаштуваннями приватності та розширеннями. У результаті сама заявка або покупка може відбутися, але рекламний кабінет не завжди отримує той самий обсяг даних, який уже видно в CRM, партнерці або трекері.
Тому ситуація, коли одна система показує 120 конверсій, інша — 116, а рекламний кабінет помітно менше, сама по собі не означає, що хтось рахує неправильно.
Різні системи просто можуть бачити різні ділянки однієї й тієї самої воронки.
Як працює звичайний client-side tracking
За класичної схеми багато чого відбувається безпосередньо в браузері користувача.
Умовно ланцюжок виглядає так:
реклама → сайт → браузерний тег → рекламна система
Користувач виконує дію, браузер фіксує її через встановлений тег і передає подію далі. Поки весь ланцюжок працює без обмежень, цього цілком достатньо.
Але що сильніше збір даних залежить від браузера, то більше з’являється потенційних точок, де сигнал можна втратити. Саме цю проблему добре показує вже згадана на сайті історія з Google Tag Gateway. У матеріалах Google інструмент описується як спосіб запускати Google tags через інфраструктуру самого сайту — наприклад CDN, балансувальник навантаження або вебсервер — і таким чином покращувати якість вимірювання.
Що змінюється при server-side tracking
Основна ідея server-side tracking полягає в тому, щоб не залишати всю передачу подій виключно на стороні браузера.
Частина даних проходить через серверну інфраструктуру, після чого вже передається далі в рекламну платформу, трекер або іншу систему.
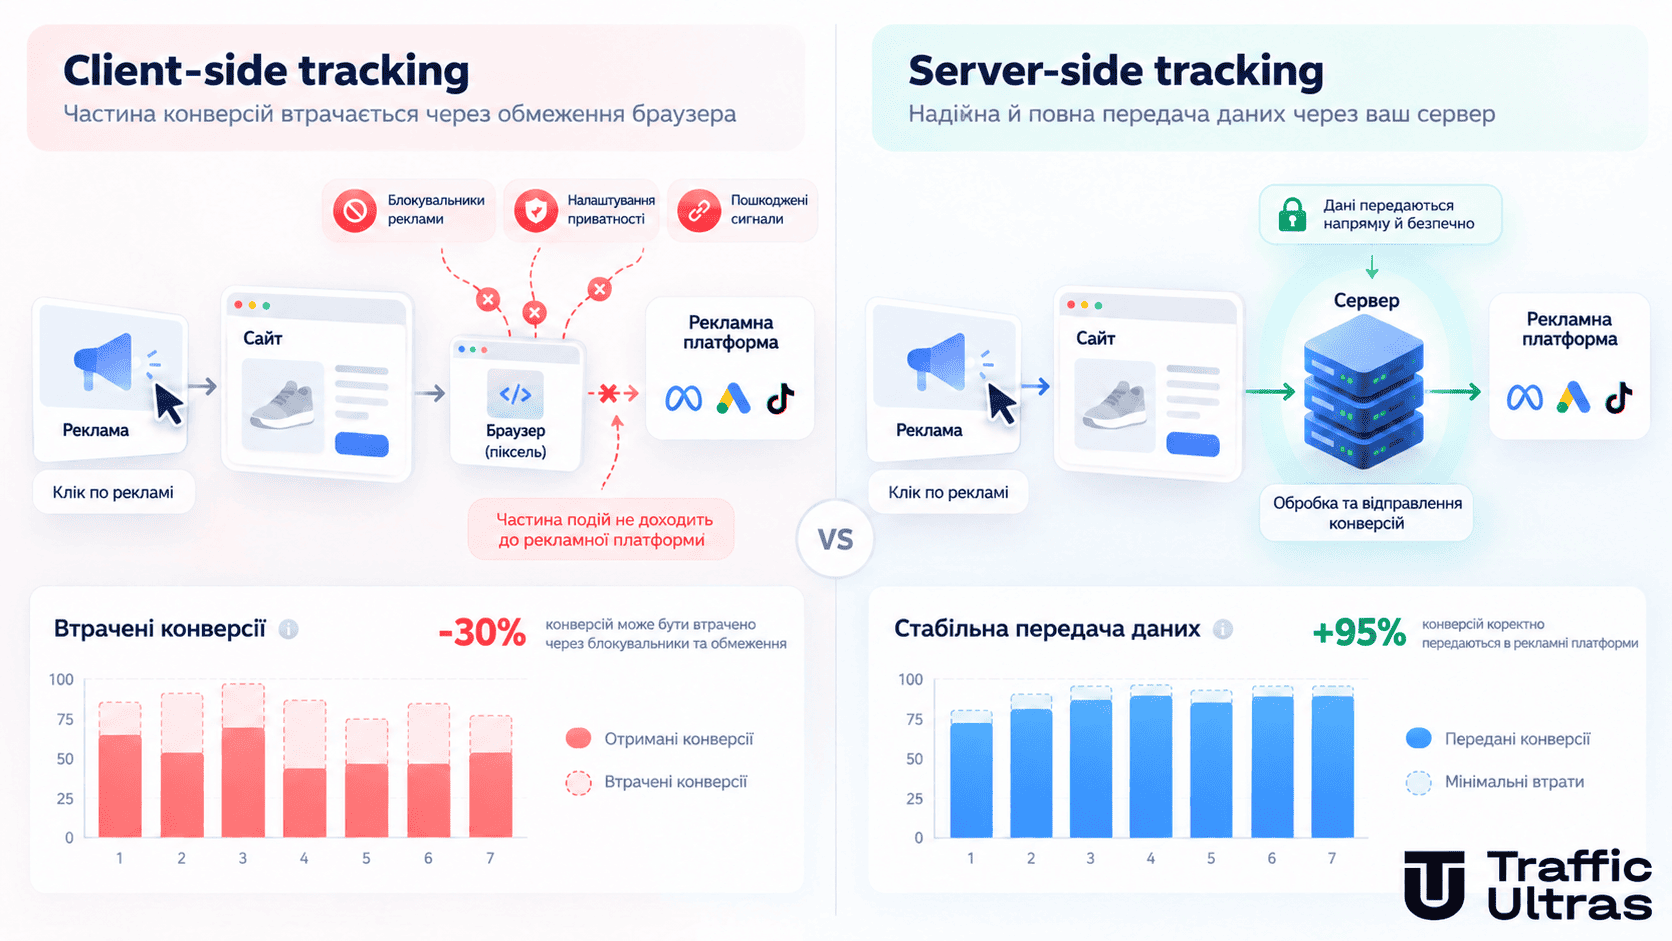
Спрощено:
користувач → сайт → сервер → рекламна система
Так з’являється додатковий контроль над тим, які дані передаються, у якому форматі та куди саме вони мають потрапити.
Але тут важливо не змішувати всі інструменти в одне поняття. Server-side GTM, Meta CAPI, postback і Google Tag Gateway — не одне й те саме. Вони можуть вирішувати схожу проблему стабільнішої передачі даних, але працюють по-різному.
Google Tag Gateway, наприклад, радше знаходиться поруч із цією логікою, ніж є класичним server-to-server трекінгом у звичному для арбітражника розумінні.
Що саме робить Google Tag Gateway
Суть Tag Gateway полягає в тому, що Google tag може обслуговуватися через інфраструктуру та домен рекламодавця, а не лише стандартним шляхом безпосередньо через інфраструктуру Google.
Для рекламодавця це дає стабільнішу схему збору first-party даних і зменшує залежність від частини обмежень звичайного браузерного трекінгу. Google зараз загалом активно просуває ідею Data Strength — що якісніші та повніші сигнали, то більше даних отримує автоматична оптимізація.
Саме тому показник понад 20% uplift у Demand Gen цікавий не сам по собі. Набагато важливіше інше: Google прямо показує, наскільки серйозно якість передачі даних уже пов’язана з ефективністю автоматизованих кампаній.
Докладніше механіку вже розбирали в окремій новині про Google Tag Gateway
Чому втрачені події впливають не лише на красиву статистику
Можна подумати: якщо продаж відбувся й гроші отримані, яка різниця, побачив його рекламний кабінет чи ні?
Різниця з’являється тоді, коли кампанія оптимізується автоматично.
Google Ads, Meta та інші рекламні системи використовують отримані конверсії як сигнал для алгоритмів. Якщо платформа бачить лише частину реальних цільових дій, вона отримує неповну інформацію про те, які користувачі насправді приносять результат.
Уявімо, що реклама привела 100 покупців, але рекламна система змогла коректно пов’язати з кампанією лише 80. Для бізнесу продажі нікуди не зникли. А для алгоритму решта 20 користувачів виглядають значно менш зрозумілими.
На невеликому тесті різниця може бути майже непомітною. На великих обсягах неповні дані вже можуть впливати на навчання кампанії, розподіл бюджету та роботу автоматичних стратегій.
Де тут postback
Арбітражникам серверна передача даних давно знайома хоча б за postback.
Користувач виконав цільову дію в рекламодавця, після чого партнерська система надсилає інформацію про конверсію в трекер. Сам браузер користувача в цій передачі вже не потрібен.
Умовно:
партнерка → трекер
Але далі виникає інше завдання — повернути корисний сигнал рекламній системі:
трекер / сервер / CRM → рекламна платформа
Тому postback і server-side tracking не обов’язково замінюють одне одного. Вони можуть працювати всередині однієї інфраструктури й закривати різні ділянки передачі даних.
За схожим принципом працює Meta CAPI
У Meta для серверної передачі подій використовується Conversions API. Він дозволяє передавати дані про події безпосередньо із серверної сторони та доповнювати інформацію, яку збирає браузерний Pixel.
Через це часто використовується комбінована схема:
Pixel + CAPI
Pixel фіксує доступні події в браузері, а серверна передача допомагає доповнити дані.
У Google екосистема влаштована трохи інакше: є Tag Gateway, Enhanced Conversions, Data Manager та інші інструменти, які поступово посилюють роботу з first-party даними.
Загальний тренд при цьому один: рекламні платформи намагаються менше залежати від одного браузерного сигналу.
Головна проблема server-side — події можна задвоїти
Щойно одна й та сама конверсія починає передаватися кількома способами, з’являється протилежна проблема.
Уявімо, користувач здійснив покупку. Pixel успішно передав подію з браузера, а сервер через секунду надіслав ту саму покупку ще раз.
Якщо система вирішить, що це дві різні конверсії, статистика вже буде завищеною.
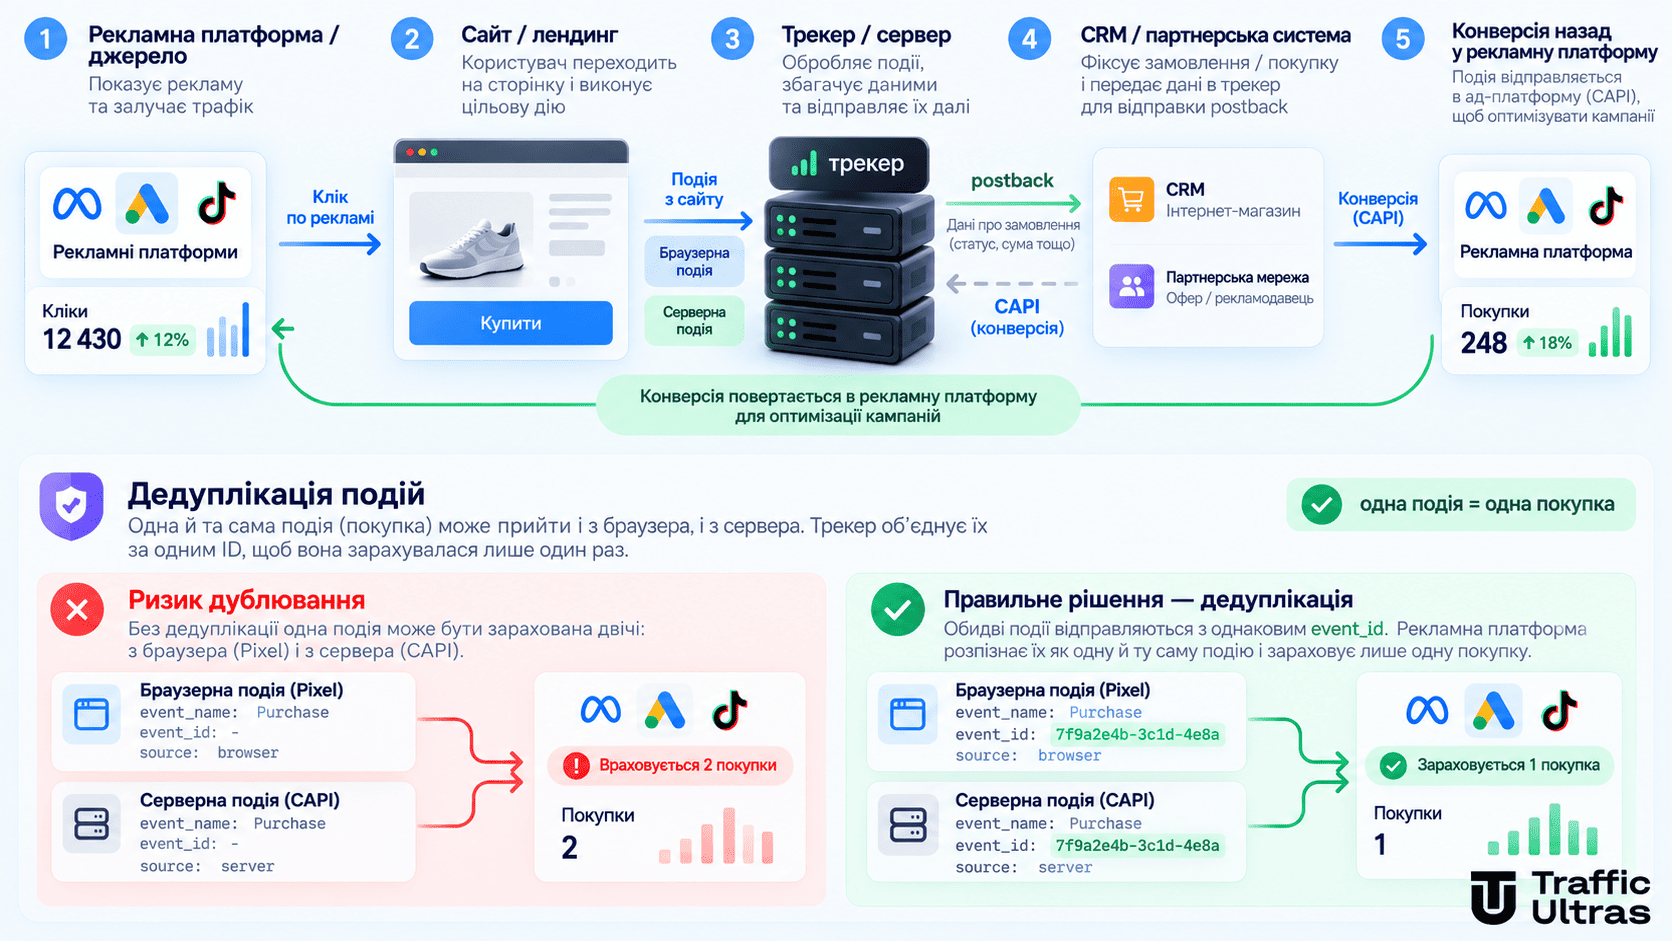
Тому при гібридній передачі подій особливо важлива дедуплікація. Зазвичай одній покупці або події присвоюється єдиний ідентифікатор, який передається різними способами. Тоді платформа розуміє, що отримала два сигнали про одну дію.
Тобто завдання server-side tracking полягає не в тому, щоб передати якомога більше конверсій.
Потрібно передати реальні події максимально повно, але не порахувати одну покупку двічі.
Навіщо тоді потрібен звичайний трекер
Трекер при цьому нікуди не зникає.
Якщо команда працює з кількома джерелами, лендингами, оферами та партнерками, саме він допомагає зібрати ланцюжок в одному місці: визначити джерело кліку, зберегти параметри, прийняти postback і пов’язати конверсію з конкретною кампанією.
Server-side передача вирішує трохи інше завдання — допомагає донести потрібні сигнали далі.
Тому трекер і server-side tracking логічно розглядати не як конкуруючі рішення, а як частини однієї інфраструктури.
Трекер показує, що сталося всередині воронки. Серверна передача допомагає потрібним платформам отримати дані про цю подію.
Коли server-side справді має сенс
Не кожній тестовій кампанії потрібна складна серверна інфраструктура.
Якщо ви лише перевіряєте офер на невеликому обсязі, статистика між системами сходиться, а рекламна платформа отримує достатньо даних для оптимізації, ускладнювати схему просто заради модного терміна особливого сенсу немає.
Інша справа, коли обсяги зростають, використовуються автоматичні стратегії, а між фактичними конверсіями та даними кабінету з’являється стабільна різниця.
Особливо чутливо це для e-commerce, лідогенерації та інших моделей, де алгоритм постійно навчається на покупках, заявках або цінності конверсії.
Що більше рішень рекламний алгоритм ухвалює автоматично, то важливіша якість даних, на яких він навчається.
З чого починати впровадження
Починати краще не з купівлі сервера та налаштування десятка нових інтеграцій, а з перевірки поточної статистики.
Порівняйте дані рекламного кабінету з CRM, трекером або партнерською програмою. Подивіться не лише на підсумкову кількість конверсій, а й на стабільність розбіжності.
Якщо втрати справді є, далі вже можна розбиратися, на якій ділянці вони виникають і який інструмент вирішує саме вашу проблему: Google Tag Gateway, CAPI, server-side GTM, Enhanced Conversions або інша серверна інтеграція.
Після підключення потрібно знову звірити дані й обов’язково перевірити дедуплікацію.
Якщо раніше кабінет показував 100 покупок, а після налаштування раптом почав показувати 170 за незмінної фактичної виручки, насамперед варто перевірити не «зростання ефективності», а чи не передається одна подія кілька разів.
Що в підсумку
Недавня новина про Google Tag Gateway у Demand Gen добре показує, наскільки сильно рекламні платформи сьогодні залежать від якості даних. Google повідомляє, що рекламодавці з посиленим Data Strength і Tag Gateway у середньому отримують понад 20% conversion uplift у Demand Gen, але цей показник не можна автоматично переносити на будь-яку кампанію.
Головний висновок тут набагато ширший за одну функцію Google.
Рекламному алгоритму недостатньо просто отримати бюджет і креатив. Йому потрібні нормальні сигнали про те, які користувачі справді виконують цільові дії.
Тому server-side tracking поступово перестає бути виключно технічною темою для аналітиків. На великих обсягах він стає частиною роботи з рекламними алгоритмами, атрибуцією та оптимізацією.
І якщо рекламний кабінет регулярно показує менше конверсій, ніж ви реально отримуєте, можливо, проблема не в офері й не в якості трафіку.
Іноді частина результату просто губиться між кліком користувача та моментом, коли рекламна система мала його побачити.


Нема коментарів